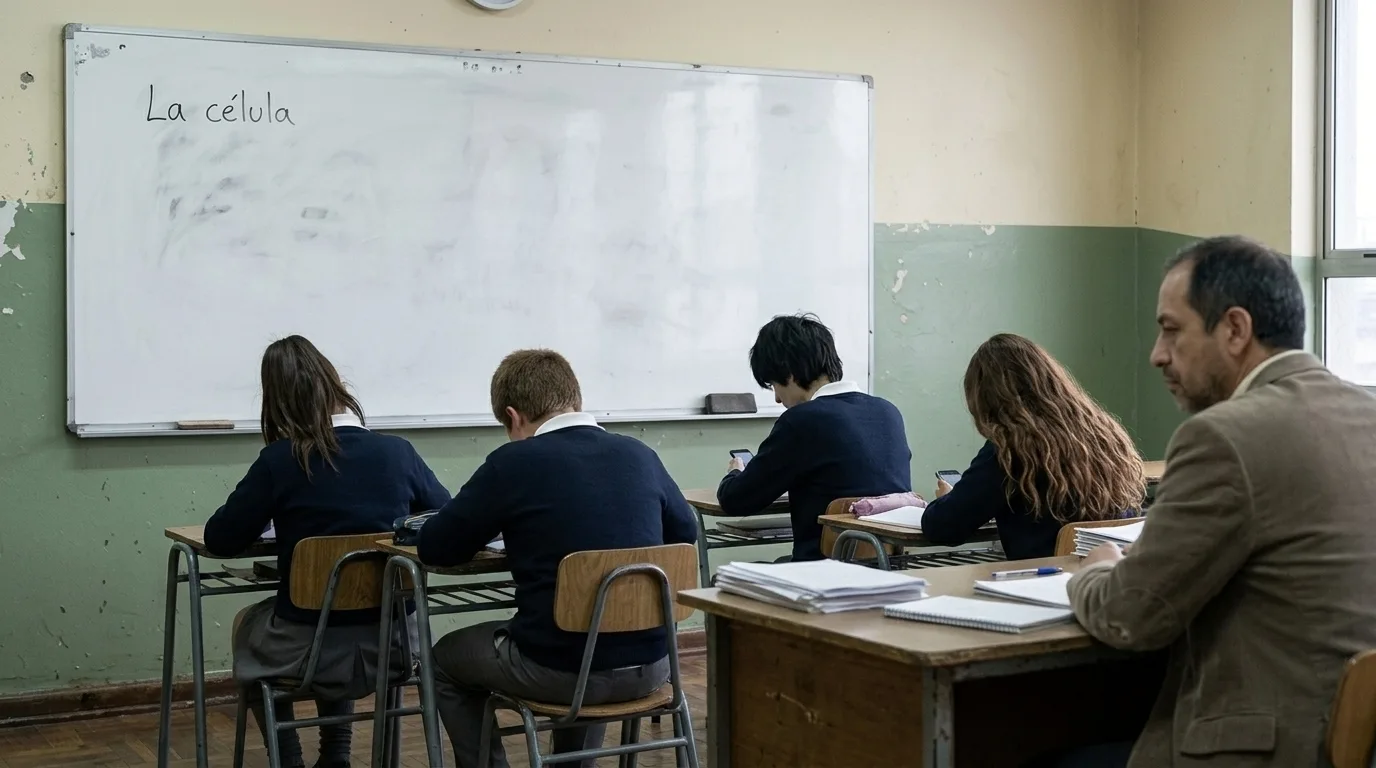
Le puse un 5 de 10 a mi propio video. Lo había producido completo con Claude Code en modo autónomo: 113 segundos, 53 imágenes y 40 clips. Cada plano se veía bien por separado, pero el profesor cambiaba de lugar en cada corte: al frente, al fondo, sentado al costado entre los alumnos. Mi nota de esa noche fue corta: «mucha incoherencia en posicionamiento del personaje». Lo rehice conectando Claude Code a Blender: primero una maqueta 3D del colegio, después una cámara por plano y recién al final la imagen. Aquí te muestro el método completo, con el material real.
Si no conoces el sistema con el que produzco video con IA, lo conté en qué es Claude Code y cómo produzco documentales con él. Ese pipeline tenía un punto ciego: el espacio. Este artículo es cómo lo cerré.
Por qué la IA pierde el lugar de las cosas entre un plano y otro
Cada imagen se genera desde cero: el modelo no tiene un set, tiene una descripción, y una descripción admite mil salas distintas. Si escribes “el profesor frente a la pizarra y los alumnos en sus bancos”, el modelo inventa dónde está la puerta, cuántas filas hay y hacia dónde mira cada uno. En la toma siguiente vuelve a inventar. Por separado, cada imagen es correcta; juntas, no forman un lugar.
No es solo mi problema. En una encuesta a 65 cineastas que trabajan con IA, publicada en un taller de CVPR 2025, el control de cámara obtuvo 6,35 de 7 en importancia, mientras que las herramientas actuales lo resuelven con un 4,71. La consistencia de los personajes sale casi igual de mal.
En mi primer intento hice lo que recomienda casi todo tutorial: una planta del colegio vista desde arriba como referencia y el muro declarado en cada prompt. No alcanzó. El modelo de imagen igual ponía la pizarra detrás de los alumnos. El de video fue peor: cuando le pedí que el reloj y la pizarra “no cambiaran”, hizo aparecer un reloj en un plano que no lo tenía. La IA dibuja lo que nombras, aunque lo nombres para prohibirlo.
El cine ya lo resolvió hace décadas: se llama previs
Antes de filmar una escena cara, los grandes estudios la arman en 3D simple para decidir dónde va cada cámara: eso es la previsualización, o previs. Industrial Light & Magic tiene un departamento dedicado a esto, y The Third Floor hizo la previs de películas como Eternals. Un curso de SIGGRAPH la define como la herramienta con la que el director le comunica su visión al equipo, para que pueda planificarla y ejecutarla.
La idea de aplicarla al video con IA la tomé del canal de Aidan Stanik, que arma escenas en Blender en gris, sin texturas ni luces, y las usa como guía para un modelo de video. Investigué sus videos a fondo antes de tocar nada. Me quedé con el principio y lo adapté: en mi método, la maqueta no va directo al modelo de video, sino que se convierte en la referencia principal de cada imagen. Más abajo te explico por qué.
Qué necesitas para conectar Claude Code a Blender
Necesitas tres piezas: Claude Code, Blender y el conector MCP que los une; se instalan en una tarde y dos de ellas son gratis. Yo no instalé nada a mano. Le pedí a Claude Code que instalara Blender en mi disco externo, que conectara el MCP oficial y que lo probara leyendo una escena. MCP es el estándar que deja a un agente de IA usar una herramienta externa; lo expliqué con un caso real en cómo conecté Claude Code a n8n por MCP.
| Pieza | Qué hace | Costo |
|---|---|---|
| Claude Code | El agente que escribe el código, lo ejecuta en Blender y revisa el resultado | Desde el plan inicial de USD 20 al mes |
| Blender 5.2 LTS | Software 3D libre; esta versión tiene soporte hasta 2028 | Gratis |
| MCP Server de Blender Lab | El conector oficial, hecho por los desarrolladores de Blender. Anthropic lo anunció como conector de Claude en abril de 2026 | Gratis |
| Skills de prompts | Instrucciones de oficio para escribir prompts de imagen y de cámara. Yo uso las de Higgsfield, que son públicas | Gratis |
| Modelos de imagen y video | Generan las imágenes y los clips a partir de la maqueta | Pago por uso |
Revisa tu equipo antes de empezar. Blender pide como mínimo 8 GB de RAM y una tarjeta gráfica de 2 GB, y recomienda 32 GB y 8 GB de memoria gráfica. En Mac, desde la versión 5.0 solo funciona con chip Apple Silicon. Si quieres ver cómo tengo montado Claude Code en el día a día, lo conté en cómo evolucionó mi setup con Claude Code.
Un detalle que importa: existe un MCP comunitario mucho más popular, con más de 32 mil estrellas en GitHub. Le pedí a Claude Code que lo auditara antes de instalarlo. No encontró nada malicioso, pero trae telemetría activa por defecto, así que me quedé con el oficial.
Paso 1: la maqueta del set, construida por código
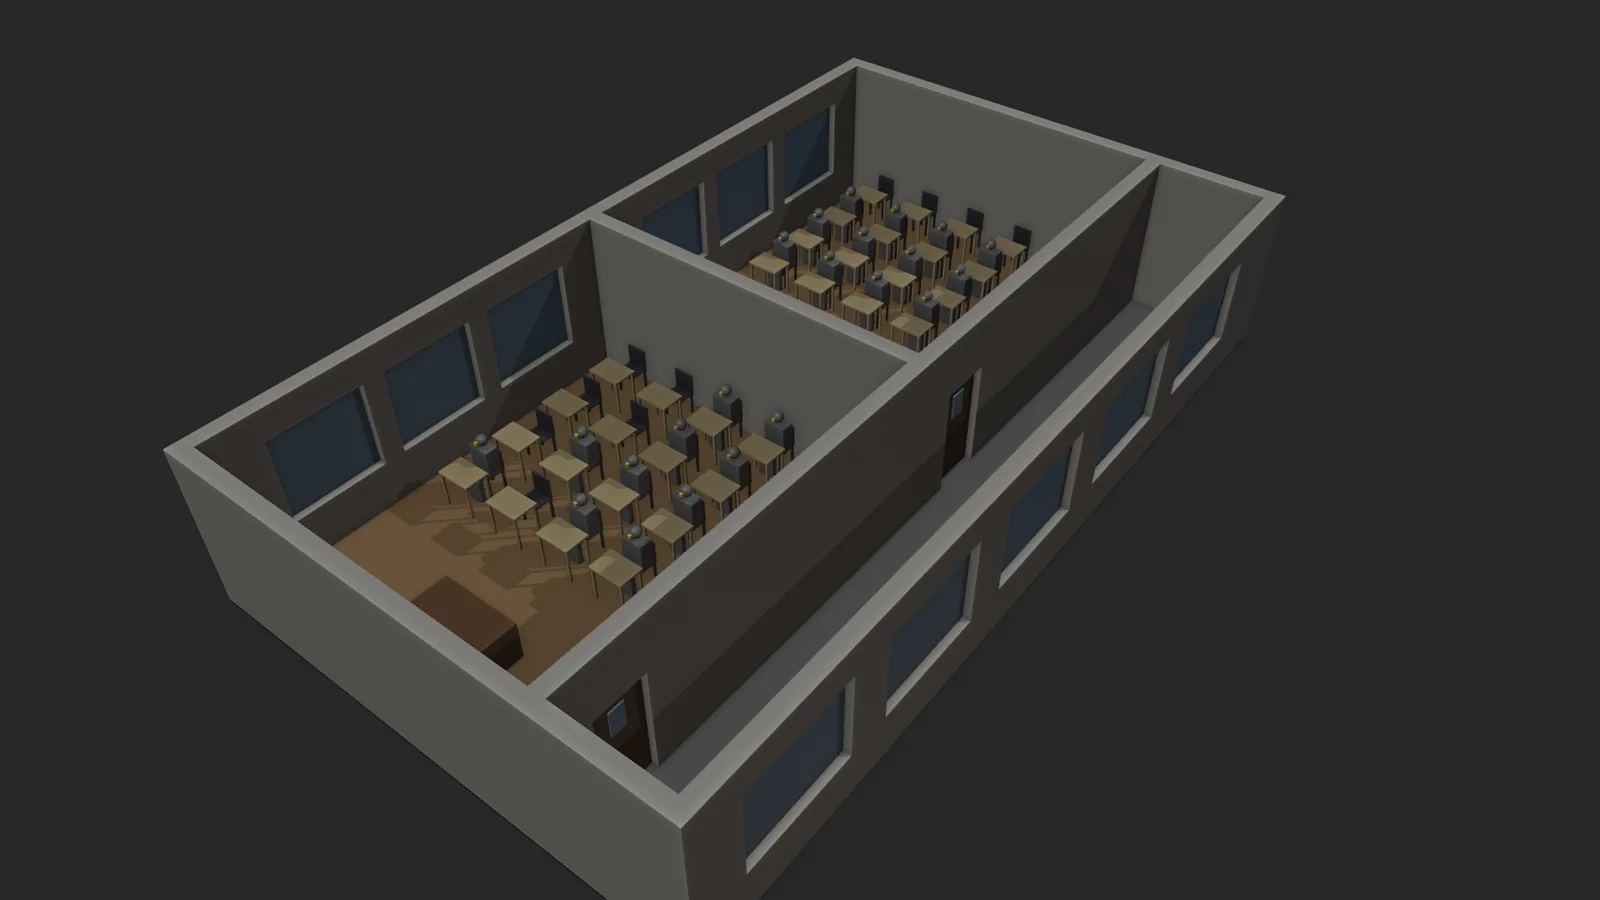
La maqueta es el colegio completo a escala real, armado por un script que escribe Claude Code y que Blender ejecuta en segundo plano. Tiene dos aulas, el pasillo, las ventanas, las puertas, los bancos y 29 alumnos ubicados según la planta: 14 en la primera aula, en 4 filas de 5 bancos, y 15 en la segunda. No moví un solo vértice con el mouse.
Que sea código tiene una ventaja que no se ve en la imagen. Si algo está mal, se corrige el script y el colegio se vuelve a construir idéntico, con el cambio incluido. Así, la maqueta deja de ser un dibujo y pasa a ser la fuente de verdad: cuántas filas hay, dónde está la puerta, a qué distancia queda la pizarra. Cuando la vi terminada, se lo dije a Claude con estas palabras: «ahora sí es muchísimo más control de los fondos de las imágenes».
Paso 2: muñecos de colores y una cámara por plano
Sobre la maqueta, cada personaje es un muñeco articulado de un color, y cada plano del guion tiene su propia cámara, con su lente y su movimiento. El previs del capítulo terminó con 41 planos y 2.330 cuadros a 24 por segundo. El alumno que copia es verde; el que duda, naranja; la que dibuja, turquesa; el del celular, morado. Con eso, en cada encuadre sé de inmediato quién está y quién no.
Las cámaras se eligen como en un rodaje real: un 85 mm en travelling lateral para el detalle del profesor caminando, un 35 mm para el aula y un 50 mm para los diálogos. Cuando la cámara acompaña a un personaje, va pegada a él, porque la caminata acelera y frena.
Aquí apareció el primer ahorro, antes de gastar un solo crédito en imágenes. La maqueta mostró que el guion pedía cosas imposibles: un 35 mm no alcanzaba a mostrar al alumno que bosteza y al profesor a la vez, y dos hombros en primer plano con un 50 mm no cabían con los bancos a 1,2 metros. Además, desde la ventanilla de la puerta no se veía a los alumnos. En un rodaje, eso lo descubres con el equipo pagado y esperando.
Paso 3: de la maqueta a la imagen fotorrealista
Cada imagen final se genera con el cuadro de la maqueta como referencia principal, y después con las fichas de los personajes y del decorado. El orden importa. Probé poner la maqueta al final de las referencias y el modelo respetaba peor el encuadre y la altura de la cámara. Lo dejé como regla: «la maqueta es muy importante que esté presente siempre como referencia principal».
Claude Code sumó dos técnicas que ningún chat puede aplicar, porque necesitan leer la escena 3D:
- Mapa de zonas. Desde cada cámara lanza rayos en una grilla de 8 por 5 y registra qué objeto hay en cada zona del cuadro. El prompt describe zona por zona lo que existe, y así desaparecen las ventanas, puertas y pizarras inventadas.
- Censo de personas. Proyecta la cabeza de cada muñeco sobre la cámara y comprueba si algo la tapa. De esa forma, el prompt lleva el número exacto de alumnos visibles.
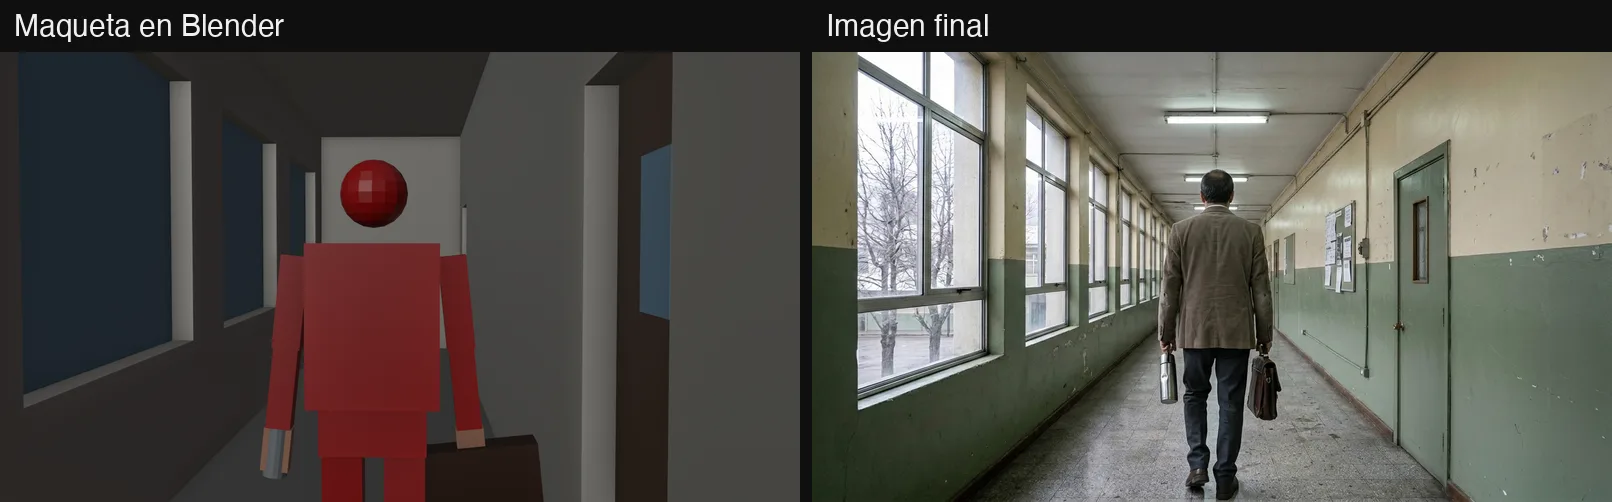
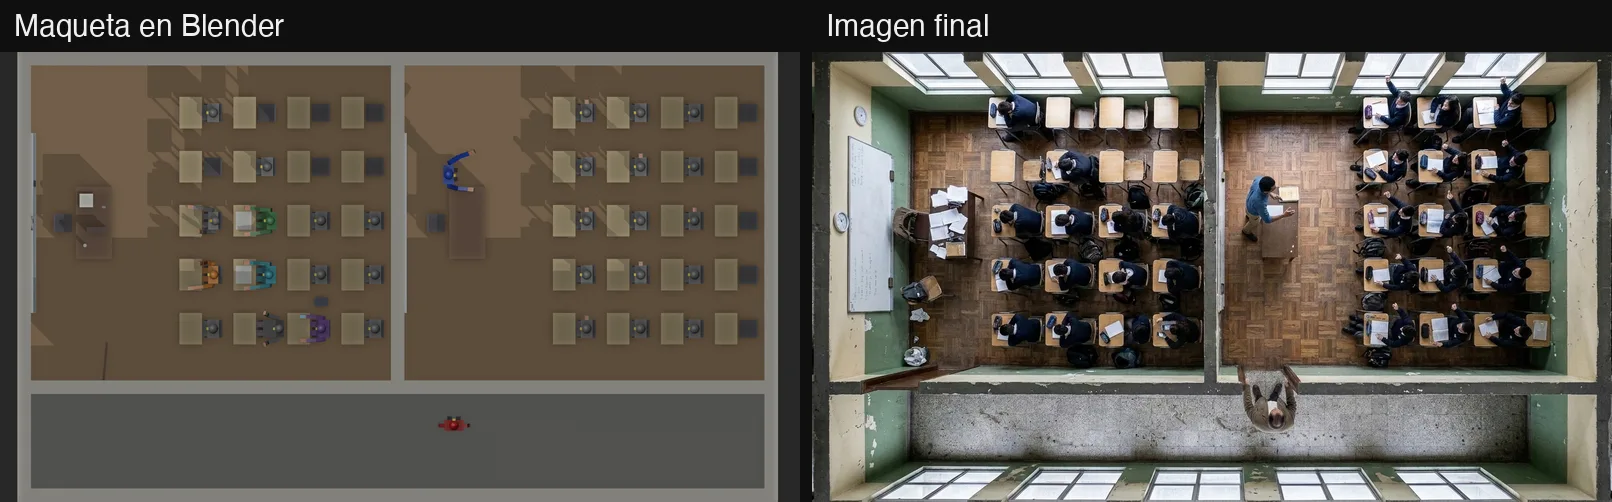
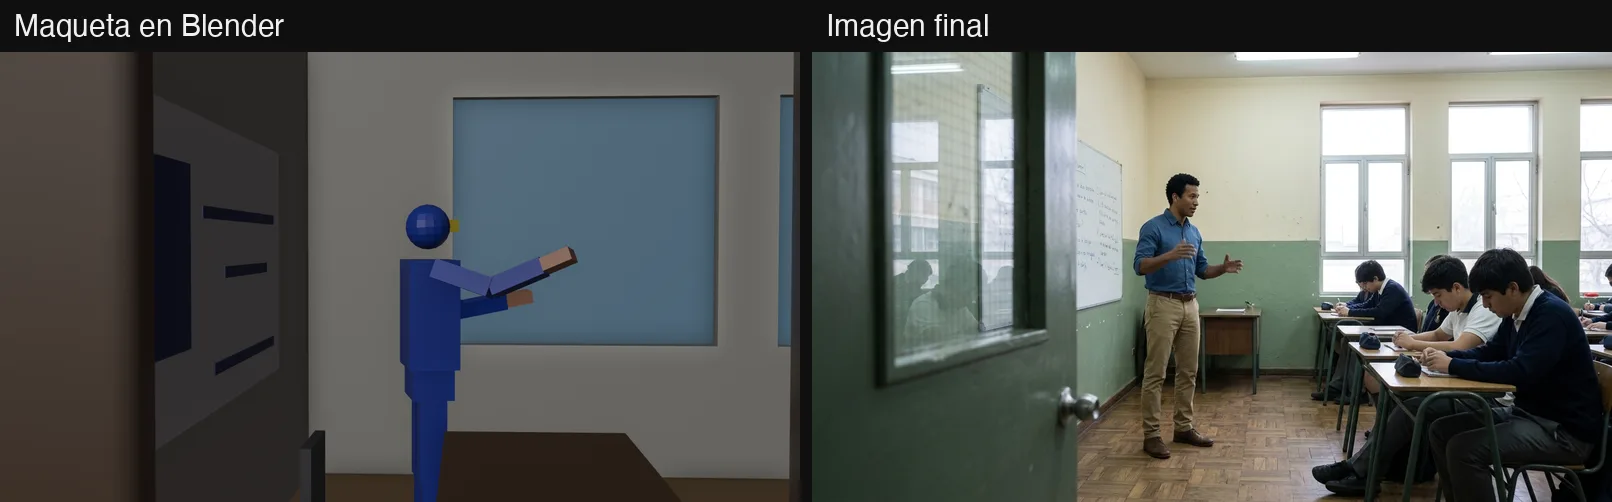
Igual tuve que corregir. El modelo agregaba filas y gente de relleno, y se lo dije sin rodeos: «no inventes más gente, no saques más a la gente que hay». Revisé los 40 planos uno por uno en un tablero de aprobación, y ninguno pasó a video sin mi visto bueno. Es la misma regla que aplico en el agente que hace el contenido de Instagram de mi marca: la IA produce, una persona aprueba.
Paso 4: de la imagen al video, con un solo movimiento por plano
Para animar, el modelo de video recibe solo la imagen aprobada y un prompt que describe lo que se mueve y un único movimiento de cámara. Usé Grok 1.5 con las skills de prompts de Higgsfield, que trabajan con esa lógica: la cámara hace una sola cosa por plano, y lo que está quieto solo se nombra si aparece en el cuadro. Puede ser un Steadicam que sigue al profesor por la espalda, un travelling lateral o la cámara fija.
El capítulo final quedó en 118 segundos y 40 planos, con voz en off, música, 14 efectos de sonido y gráficas. Claude también lo dejó armado en CapCut, con cada sonido en su pista, para que yo hiciera el ajuste fino a mano. Esa parte sigue siendo mía: la IA produce y yo decido el corte.
Lo que la maqueta todavía no resuelve
La maqueta fija el espacio y a la gente, pero no los objetos que no modelaste: el escritorio, el maletín o la chaqueta todavía pueden cambiar entre un plano y otro. Una segunda revisión del capítulo me marcó justo eso, y es lo que estoy corrigiendo ahora. La lección es simple: lo que importa para la historia, se modela.
Hay detalles que solo aparecen mirando de cerca. En un plano general, el modelo de video le puso bigote al profesor, que no tiene. Venía de una sombra de unos 12 por 4 píxeles bajo la nariz. Reescribir el prompt no sirvió; retocar la imagen, sí.
Y hay una advertencia de seguridad que conviene leer. El MCP de Blender ejecuta sin protecciones el código que escribe la IA, y la propia página de Blender recomienda usarlo en una máquina virtual. Si vas a conectarlo en un equipo con información sensible, aíslalo primero.
Personajes 3D para tu marca, sin ser modelador
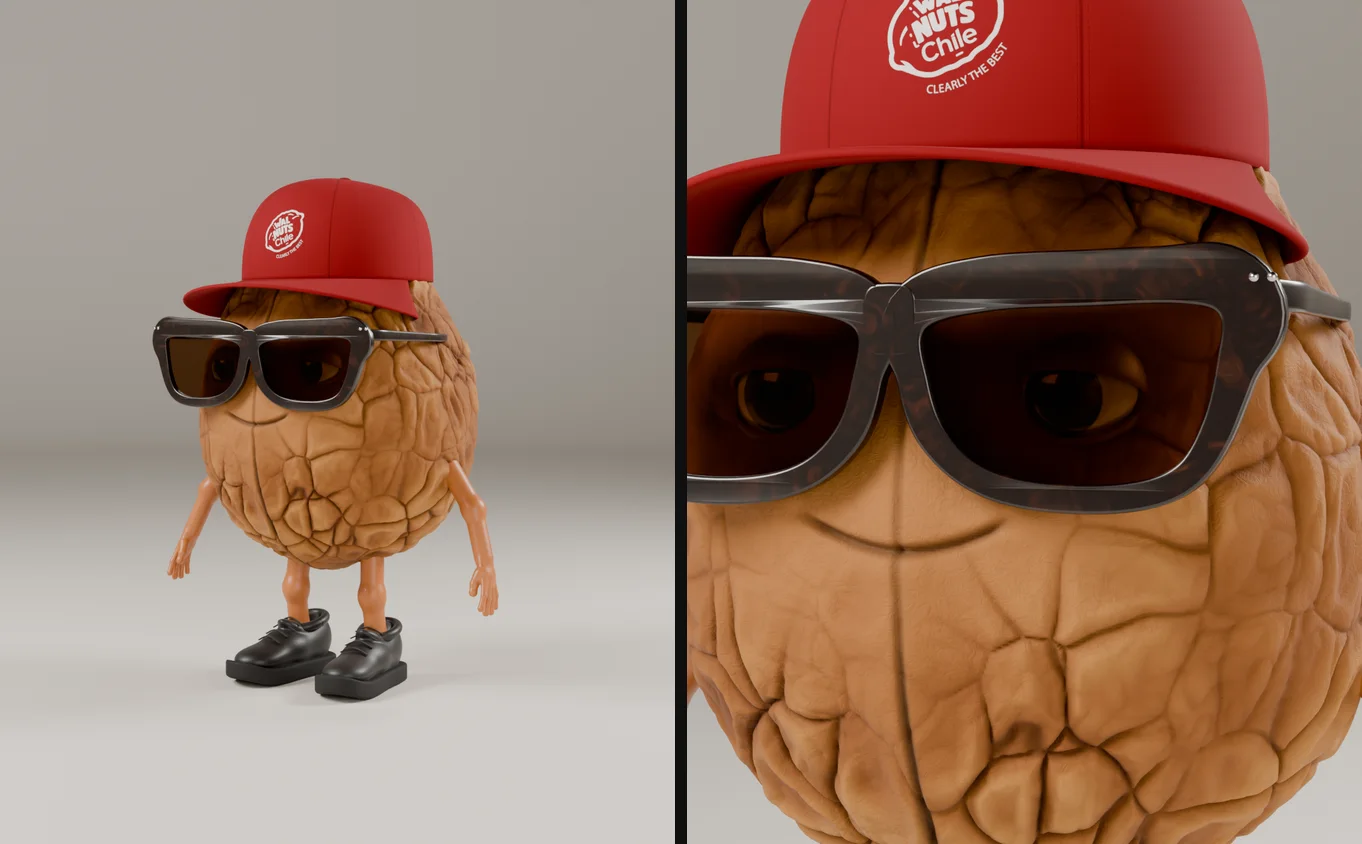
La misma conexión sirve para crear un personaje 3D de marca, listo para animar, sin saber modelar. Lo probé con Waldo, la mascota de una marca de nueces chilenas con la que trabajo. No soy modelador 3D ni diseñador gráfico. Lo que sí sé es decir qué está mal.
Waldo está hecho igual que la maqueta: por código. Un script lo regenera completo en un minuto, con 19 piezas separadas y con nombre, como los ojos y párpados que giran, las gafas, la gorra con el sello de la marca, las manos de cinco dedos y las zapatillas. La primera versión no me convenció, así que pedí más realismo en la cáscara. Claude la recalibró contra una foto real de nuez, no contra imágenes de IA, y el color medido quedó en 0,71 de saturación contra 0,69 de la nuez real. Esa vez le dije: «ahí me gustó».
Después vino el esqueleto: piernas que apoyan el pie sin patinar, brazos que se mueven libres y una caminata de 4 segundos. Claude la verificó cuadro a cuadro: el tobillo nunca se separa de su control y el pie se desliza como máximo 0,2 milímetros por cuadro. Todavía no es Pixar, pero es el tipo de acabado que hace unos años exigía un estudio de animación, y lo dirigió alguien que no sabe animar.
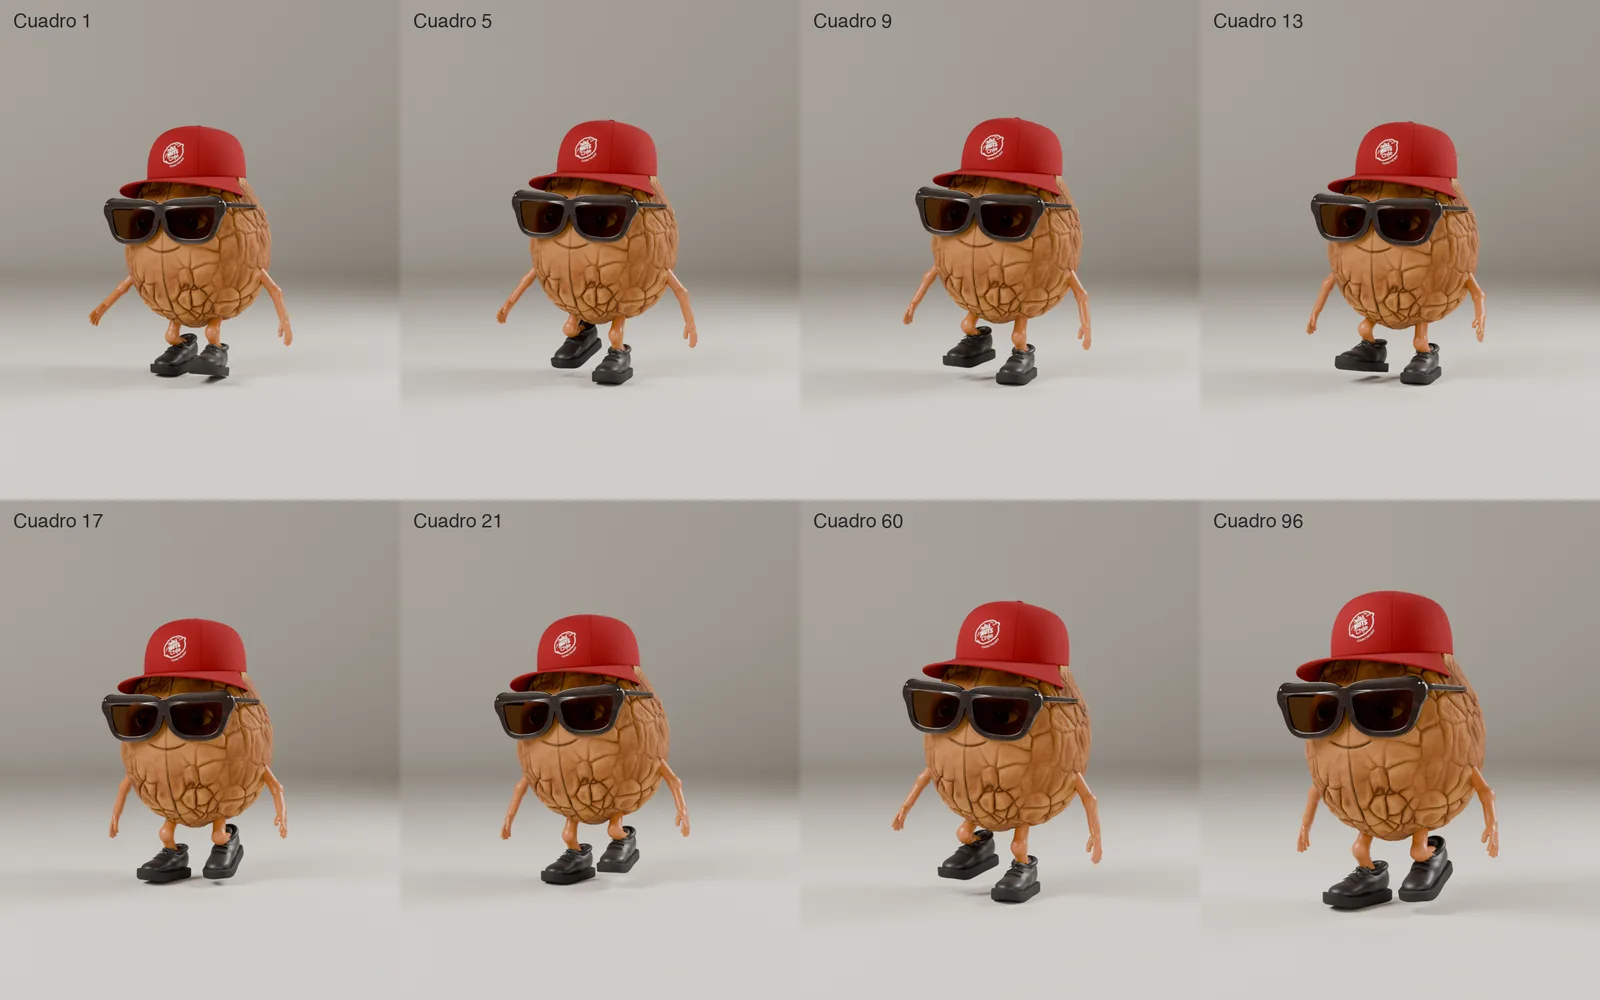
Suena fácil, y no lo es del todo. Las texturas todavía hay que hornearlas para usar a Waldo fuera de Blender, y el video final de la caminata aún hay que renderizarlo. Pero el personaje ya existe en 3D y, desde ahí, se puede poner en cualquier escena y frente a cualquier cámara.
ChatGPT te da una imagen; un agente te arma el set
Un chat te devuelve una imagen bonita; un agente conectado a Blender construye el set, mide qué ve cada cámara y escribe el prompt con esa información. Esa es la diferencia que hace que un video con IA deje de verse “hecho con IA”. El problema nunca fue la calidad de cada imagen, sino que juntas no formaban un lugar.
Para una marca esto abre algo concreto. Según IAB, la mitad de los anunciantes ya usa IA generativa para hacer sus anuncios de video, y las marcas chicas y medianas la están adoptando más rápido que las grandes. Por eso, la diferencia la va a marcar quién controla la escena y quién deja que el modelo decida. Lo mismo pasa con los personajes: una mascota en 3D aparece igual en un comercial, en un reel o en la portada de tu web, como el sistema visual que conté en cómo hacer fotos y carteles con IA que se vean como tu marca.
Si quieres probarlo, este es el orden que te recomiendo:
- Conecta Blender y el MCP oficial a Claude Code, y pídele que te describa una escena de ejemplo.
- Pide una maqueta simple de tu espacio: tu local, tu oficina o tu producto sobre una mesa.
- Pon una cámara y genera una sola imagen con la maqueta como referencia principal.
- Anima recién cuando esa imagen esté aprobada.
La conexión toma una tarde. Lo que no toma una tarde es el sistema alrededor: la maqueta como fuente de verdad, el censo de personas, la aprobación cuadro a cuadro y el criterio de qué modelar y qué dejarle al modelo.
Recursos que menciono en este artículo
Todo lo que usé para la maqueta es público; lo que cuesta es armar el método. Estos son los enlaces para empezar:
- MCP Server de Blender Lab: el conector oficial, con su instalación y su advertencia de seguridad.
- Requisitos de Blender: lo que tu equipo necesita, en la página oficial.
- Blender como guía para video con IA, de Aidan Stanik: el video que me dio la idea, en inglés.
- Skills de Higgsfield: las instrucciones de prompts de imagen y cámara que uso para animar.
Si quieres un video de marca con este nivel de control, o un personaje 3D para tu marca, conversemos. Te digo qué conviene modelar, qué dejarle al modelo y dónde poner la revisión humana desde el primer plano.